主讲人——黄文君硕士
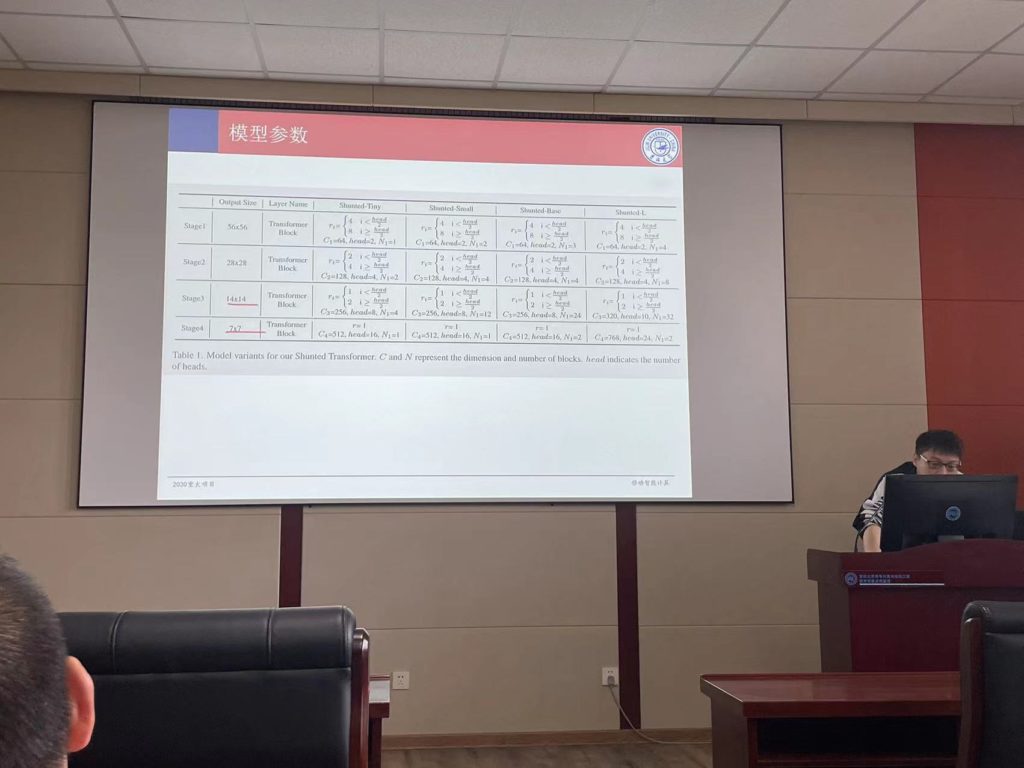
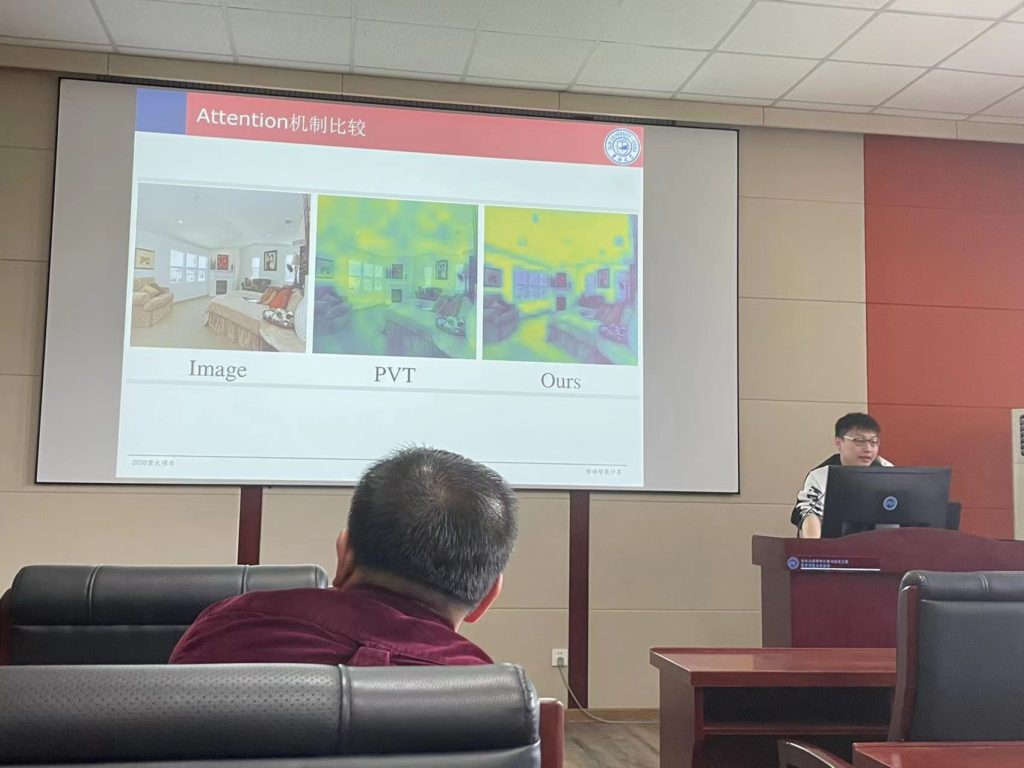
本周黄文君硕士汇报了CVPR 2022上的一篇文章《Shunted Self-Attention via Multi-Scale Token Aggregation》,它提出了一种新的自注意力机制,称为Shunted Self-Attention (SSA)。该机制通过在每一个注意力层内集成多尺度的特征提取能力,使得SSA自适应地合并针对大物体的tokens以提高计算效率,并保留针对小物体上的特征捕捉能力。基于SSA,作者提出了Shunted Transformer,可以更有效的捕获多尺度物体之间的关联。